17 kwietnia 2025
Jak działa generowanie głosu AI — trzy etapy
Część linków na tej stronie to linki partnerskie — jeśli kupisz przez nie subskrypcję, dostaniemy prowizję. Nie wpływa to na kolejność ani na oceny: ranking powstał na podstawie testu opisanego w sekcji „Jak testujemy".
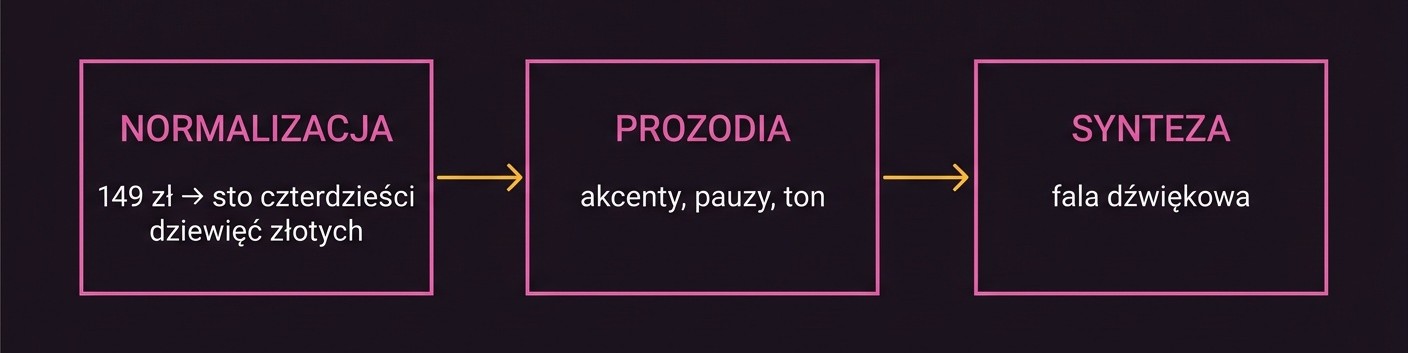
Generator głosu AI zamienia tekst na dźwięk w trzech krokach: normalizuje zapis, przewiduje jak zdanie ma zabrzmieć, a potem syntezuje falę dźwiękową. Kluczowa różnica wobec starszych syntezatorów polega na tym, że model nie skleja nagranych próbek, tylko generuje przebieg dźwięku od zera — i dlatego potrafi zaakcentować słowo, którego nigdy wcześniej nie widział.
Krok 1: normalizacja tekstu
Zanim cokolwiek zabrzmi, tekst musi zostać przepisany na formę mówioną. Ten etap decyduje o większości błędów, które potem słychać.
149 zł→ „sto czterdzieści dziewięć złotych”23.09→ „dwudziestego trzeciego września” albo „dwadzieścia trzy kropka zero dziewięć” — zależnie od tego, czy model rozpozna kontekst datydr hab.→ „doktor habilitowany”
W języku polskim ten etap jest trudniejszy niż w angielskim, bo liczebniki się odmieniają. „149 złotych” i „od 149 złotych” wymagają tej samej formy, ale „149 złoty” już nie. Stąd najczęstszy błąd, jaki słychać w polskich nagraniach: liczba przeczytana w złej formie gramatycznej.
Praktyczny wniosek: jeśli w Twoim tekście są kwoty albo daty, zapisz je słownie. To jedna zmiana, która eliminuje większość wpadek.
Krok 2: przewidzenie prozodii
Prozodia to melodia wypowiedzi — rozkład akcentów, tempo, wysokość tonu i pauzy. Model przewiduje ją na podstawie całego zdania, nie pojedynczych słów. Dlatego to samo słowo brzmi inaczej na początku zdania oznajmującego i na końcu pytania.
Praktycznie steruje tym interpunkcja:
- przecinek — krótka pauza, zawieszenie tonu
- kropka — dłuższa pauza, opadnięcie tonu
- znak zapytania — wzniesienie tonu na końcu
- myślnik — najdłuższa pauza, często z podkreśleniem tego, co po nim
To nie jest metafora — te znaki realnie trafiają do modelu jako sygnał. Tekst bez interpunkcji brzmi jak lista słów, nawet w najlepszym narzędziu.
Krok 3: synteza fali dźwiękowej
Ostatni etap zamienia przewidzianą prozodię w konkretny dźwięk. Modele robią to na poziomie próbek albo reprezentacji pośredniej (spektrogramu), którą dopiero wokoder przekłada na falę.
Dla użytkownika liczy się jeden skutek: jakość jest wynikiem modelu, nie parametrów eksportu. Zapisanie tego samego nagrania w WAV zamiast MP3 nie sprawi, że intonacja będzie lepsza — poprawi tylko to, co wynika z kompresji.
Dlaczego wybór głosu ma większe znaczenie niż wybór modelu
To nasze własne ustalenie z testu i nie znaleźliśmy go nigdzie indziej.
Każdy głos w bibliotece to osobny zestaw wag nałożony na ten sam model bazowy. W efekcie różne głosy tego samego modelu radzą sobie różnie z tymi samymi trudnościami. W naszym teście zdanie z liczbą „149 złotych” zostało przeczytane bezbłędnie głosem Alice, a głosy Charlotte i Lily zgubiły końcówkę — przy identycznym modelu ElevenLabs Multilingual v2 i identycznym tekście.
Co z tym zrobić: zanim wybierzesz głos na stałe, przepuść przez niego fragment swojego realnego tekstu — z Twoimi liczbami i nazwami własnymi. Darmowy plan w zupełności na to wystarczy i do tego właśnie służy.
Klonowanie głosu — jak to działa
Klonowanie to dostrojenie modelu do konkretnej barwy na podstawie nagrania próbki. W ElevenLabs wystarczy około minuty czystego materiału, żeby model mówił po polsku Twoim głosem.
Dwie rzeczy, o których warto wiedzieć:
- Funkcja jest dostępna od planu Creator za 22 $, nie od najtańszego Startera — wbrew temu, co podaje wiele poradników. W Murf AI klonowanie to osobno płatny dodatek do planu Enterprise.
- Klonowanie cudzego głosu bez zgody jest w Polsce naruszeniem dóbr osobistych, niezależnie od tego, co dopuszcza regulamin narzędzia.
Chcesz usłyszeć, jak to wypada w praktyce? Posłuchaj naszych nagrań albo zobacz porównanie narzędzi.